Fra Oppgavefangst til Arbeidsflyt: Hvordan humanoide roboter lærer en fabrikkjobb
Ved å registrere operatørene som allerede utfører arbeidet, og deretter omgjøre det til en distribusjonsklar humanoid arbeidsflyt. Slik får Motions Field Deployment Engineers og AI Workflow Builder en robot til å utføre dine oppgaver.
Motion1 Inc. ·
Slutten på robotprogrammering slik vi kjenner den
Så lenge roboter har eksistert i industrien, har det krevd spesialisert programmering for å få dem til å utføre nyttig arbeid. Enten språket var proprietært – som teach-pendanter brukt for industriarmer – eller generelle som Python og C++, var den grunnleggende begrensningen den samme: et menneske med dyp teknisk kunnskap måtte manuelt spesifisere alle aspekter av robotens atferd, fra høynivå oppgavelogikk ned til individuelle leddbaner.
Fysisk AI bryter denne begrensningen. Når en modell kan observere en oppgave utføres og utlede intensjonen bak bevegelsen, flyttes spesifisering av atferd fra å skrive kode til å vise arbeidet.
Denne begrensningen formet hele økonomien innen robotikk. Det betydde at hver distribusjon krevde dyrt ingeniørtalent. Det betydde at hver ny oppgave krevde en ny programmeringsinnsats. Det betydde at personene som forsto arbeidet – driftslederne og linjearbeiderne – var separert fra personene som kunne programmere robotene av et oversettelseslag av konsulenter og ingeniører som la til kostnad, tid og misforståelser i hvert trinn.
Egosentrisk oppgavefangst er teknologien som oppløser denne begrensningen. En driftsleder viser hva som må gjøres – tatt opp fra deres eget synspunkt mens de utfører det, sammen med en muntlig beskrivelse av trinnene: plukke produkter fra transportbåndet, inspisere for defekter, pakke i esker med seks, forsegle og palletere. Field Deployment Engineers gjør denne fangsten om til en distribusjonsklar arbeidsflyt i AI Workflow Builder. Ingen ingeniøransettelse fra produsentens side. Ingen robotikkgrad. Ingen måneder med iterasjon på fabrikkgulvet.
Implikasjonene strekker seg langt utover bekvemmelighet. Denne modellen endrer fundamentalt hvem som kan distribuere roboter, hvor raskt de kan distribueres, og til hvilken kostnad. Det er for robotikk hva regnearket var for finansiell modellering, hva nettleseren var for informasjonstilgang, og hva smarttelefonen var for personlig databehandling: en teknologi som flytter en kraftig kapasitet fra spesialister til alle.
Inne i pipelinen
Den tilsynelatende enkelheten ved å vise en oppgave og motta en fungerende arbeidsflyt skjuler en sofistikert pipeline av AI-agenter som arbeider i samspill. Å forstå hva som skjer bak kulissene er nyttig for å evaluere modenheten og påliteligheten til ulike distribusjonsplattformer.
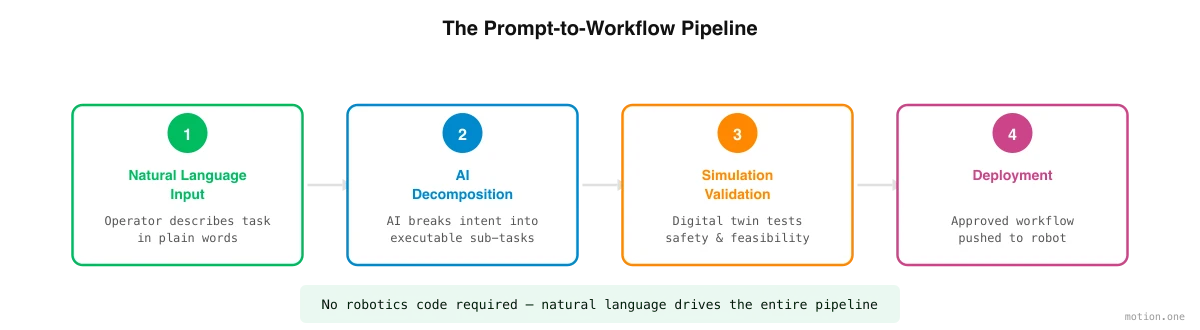
Pipelinjen begynner med oppgavedekomponering. En spesialisert AI-agent analyserer den innfangede oppgaven – opptakene og operatørens beskrivelse av trinnene – og bryter den ned i diskrete manipulasjonstrinn. "Pakke produkter i esker" blir en sekvens av atomære handlinger: nærme seg transportbåndet, identifisere produktet, gripe med passende kraft, transportere til esken, orientere riktig, plassere, slippe, gjenta til esken er full, forsegle esken, transportere til pallen, og stable i henhold til det definerte mønsteret. Denne dekomponeringen må ta hensyn til rekkefølgen av operasjoner, avhengighetene mellom trinnene, og beslutningspunktene der roboten må velge mellom alternative handlinger.
Deretter skaper en scene-genereringsagent en tredimensjonal simulering av det virkelige miljøet. Ved å bruke fotografier og video av den faktiske fabrikken – tatt med vanlige kameraer – rekonstruerer agenten geometrien, identifiserer nøkkelobjekter (transportbånd, esker, produkter, paller), og tildeler realistiske fysiske egenskaper (masse, friksjon, deformerbarhet) til hvert element. Resultatet er en digital tvilling spesifikk for produsentens anlegg.
En policy-treningsagent tar deretter over, og bruker forsterkningslæring og teleoperasjonsdata på stedet for å trene humanoiden til å utføre hvert trinn innenfor simuleringen. Roboten øver tusenvis av iterasjoner per time, og mottar belønninger for vellykket oppgaveutførelse og straffer for feil. Gjennom denne prosessen utvikler den en kontrollpolicy – en kartlegging fra sensorisk input til motorisk output – som oppnår målnøyaktigheten for hvert trinn.
En distribusjonsagent validerer den trente policyen gjennom en rekke tester, håndterer sim-til-virkelig-overføringsprosessen, og administrerer overleveringen til fysisk maskinvare med sanntidsovervåking under innledende drift.
Til slutt koordinerer en orkestreringsagent mellom flere humanoider når oppgaven krever robot-til-robot-samarbeid eller når flere enheter arbeider med relaterte oppgaver i samme anlegg.
Hva oppgavefangst endrer
Skiftet fra programmering til oppgavefangst er ikke bare en endring av verktøy. Det omstrukturerer fundamentalt forholdet mellom menneskene som forstår arbeidet og robotene som utfører det.
I den tradisjonelle modellen vet driftslederen hva som må gjøres, men kan ikke kommunisere det direkte til roboten. De må forklare det til en robotikkingeniør, som tolker det (med uunngåelig tap av nyanse og kontekst), oversetter det til kode (med uunngåelige antagelser og forenklinger), og itererer (med uunngåelig avvik mellom hva som ble bedt om og hva som ble levert). Denne hviskeleken legger til måneder med tid, titusenvis av dollar i kostnad, og et vedvarende gap mellom intensjon og implementering.
I oppgavefangstmodellen formidler driftslederen arbeidet slik de allerede kjenner det: ved å gjøre det på kamera og veilede en Field Deployment Engineer gjennom det. Workflow Builder håndterer oversettelsen fra fanget oppgave til robotatferd. Tilbakemeldingssløyfen er stram – hvis den resulterende arbeidsflyten ikke samsvarer med intensjonen, sier lederen ifra, og systemet regenererer arbeidsflyten på minutter i stedet for uker.
Dette er ikke bare raskere. Det er en kvalitativ endring i hvem som deltar i automatiseringsprosessen. Den globale befolkningen av robotikkingeniører teller titusenvis. Den globale befolkningen av driftsledere, skiftledere og domeneeksperter som kan demonstrere en produksjonsoppgave teller millioner. Oppgavefangst utvider antallet mennesker som kan sette en robot i arbeid med to størrelsesordener.
Iterasjonssløyfen
Distribusjon er ikke en engangsprosess, og å behandle det som sådan ville være misvisende. De mest effektive distribusjonene bruker en iterativ sløyfe som konvergerer mot produksjonsklar kvalitet gjennom raske raffineringssykluser.
Prosessen begynner med en innledende fangst av oppgaven på et høyt nivå. Plattformen genererer en førsteutkast-arbeidsflyt og kjører den i simulering. Driftslederen gjennomgår simuleringsresultatene, identifiserer avvik mellom robotens atferd og det ønskede resultatet, og tilfører de manglende detaljene – et nytt opptak, en korreksjon, en begrensning teamet tar for gitt. Plattformen regenererer arbeidsflyten, og syklusen gjentas.
Hver iterasjon tar minutter i simulering, sammenlignet med timer eller dager på fabrikkgulvet. De fleste arbeidsflyter oppnår produksjonsklar kvalitet på tre til fem iterasjoner – en prosess som kan fullføres på en enkelt arbeidsdag. Sammenlign dette med de femti til hundre iterasjonssyklusene som tradisjonell utvikling på gulvet vanligvis krever over en periode på måneder, og akselerasjonen er tydelig.
Ærlige begrensninger
Oppgavefangst er en kraftig tilnærming, men det er ikke magi, og dens nåværende begrensninger bør forstås tydelig.
Svært fingerferdige oppgaver – å tre nåler, knytte knuter, manipulere svært små eller svært fleksible komponenter – forblir på grensen av hva nåværende systemer kan håndtere. Gapet mellom menneskelig håndfingerferdighet og humanoid griperkapasitet er reelt, selv om det minsker med hver maskinvaregenerasjon.
Nye miljøer tar lengre tid enn kjente. Den første distribusjonen i en helt ny type anlegg krever mer iterasjon enn påfølgende distribusjoner i lignende anlegg, fordi simuleringsmodellene har mindre tidligere data å trekke på.
Dynamiske miljøer der forholdene endrer seg uforutsigbart – utendørs byggeplasser, jordbruksfelt, ustrukturerte butikklokaler – er vanskeligere å simulere nøyaktig enn kontrollerte fabrikkinnstillinger, og de resulterende policyene krever mer finjustering i den virkelige verden.
Disse begrensningene er reelle i dag. De krymper også med hver distribusjon, ettersom data-svinghjulet forbedrer simuleringsnøyaktigheten og forsterkningslæringsalgoritmene møter og tilpasser seg et stadig bredere spekter av forhold. Banen er klar: det som er vanskelig i dag vil være rutine i morgen.